Хеш-таблица — это структура данных, которая использует хеш-функцию для быстрого поиска.
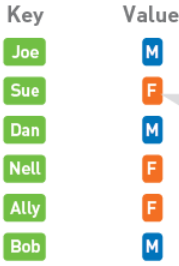
Хеш-таблица — это структура данных, которая хранит элементы в виде пар "ключ-значение". В данном примере в качестве данных используется пол каждого человека. Ключом служит имя человека, а значением — его пол.
Давайте сравним хеш-таблицу и массив на примере.
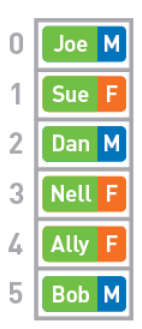
В массиве из шести ячеек нужно найти элемент данных Ally. Мы не знаем, в какой ячейке он находится. Поэтому начинаем с первой ячейки и проверяем каждую, пока не найдем нужную. Это называется линейным поиском.
Обычно ключ представляет собой идентификатор данных, а значение — их содержание.
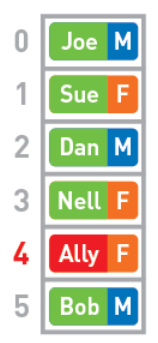
Поскольку время линейного поиска пропорционально объёму данных, хранить данные в массивах и искать их таким способом нецелесообразно.
Хеш-таблицы решают эту проблему. Рассмотрим, как это работает. Начнем с подготовки места для хранения данных. Предположим, у нас есть пять ячеек в массиве.
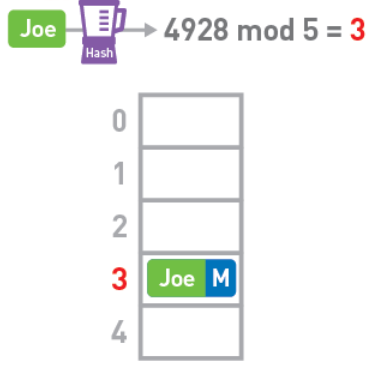
Рассмотрим ячейку для хранения данных о Джо (ячейка с ключом "Joe"). Хеш-функция вычислила хеш-значение для ключа "Joe" и вернула число 4928. Чтобы определить место в массиве, разделим это значение на количество ячеек — 5 — и найдём остаток. Операция, позволяющая найти остаток от деления, называется делением по модулю и обозначается как mod. В результате получаем число 3. Это значит, что данные о Джо будут храниться в третьей ячейке массива. Повторим эту процедуру для определения места следующего элемента данных.
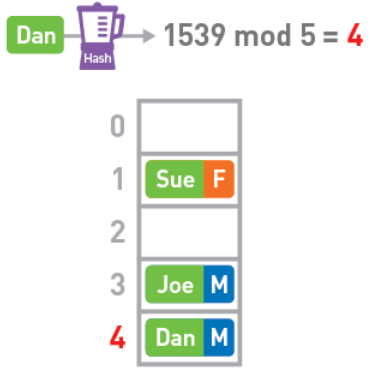
Ключ Sue дает хеш-значение 7291 с остатком 1. Это значит, что данные о Сью мы разместим в первой ячейке. Для ключа Dan (Дэн) хеш-значение равно 1539 с остатком 4. Поэтому данные Дэна пойдут в четвертую ячейку.
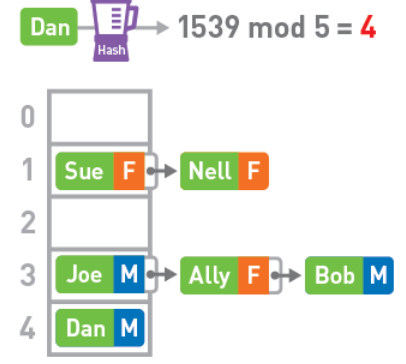
Хеш-значение ключа "Nell" равно 6276. При делении на 5 остаток равен 1, поэтому элемент с ключом "Nell" должен быть в первой ячейке массива. Но там уже находятся данные о Сью с ключом "Sue". Это называется коллизией. В этом случае новая ячейка присоединяется к существующим данным, образуя список.
Рассмотрим, как извлечь данные из такой структуры. Возьмем пример поиска значения пола (F или M) по ключу Dan. Для начала определим, в какой ячейке находится ключ Dan. Для этого вычислим его хеш-значение, которое равно 1539. Затем выполним операцию mod с количеством ячеек в массиве (помните, что оно равно 5). Результат 1539 mod 5 будет равен 4. Таким образом, мы знаем, что ключ Dan находится в четвертой ячейке массива.
Как узнать пол Элли (Ally)?
Найдите хеш-значение ключа Ally и выполните операцию mod с количеством ячеек массива. Результат будет равен 3. В третьей ячейке массива хранится не Ally, а Joe. Проверьте элементы, присоединенные к третьей ячейке в виде списка. Начинайте линейный поиск с ключа Joe.
Хеш-таблицы обеспечивают быстрый доступ к данным благодаря хеш-значениям. Если возникает коллизия, данные сохраняются в списках, что позволяет эффективно работать с неопределенным объемом информации.
Выбор правильного размера массива критически важен. Если массив слишком мал, коллизии будут происходить чаще, и поиск данных может замедлиться до линейного. Если же массив слишком велик, значительная часть ячеек останется пустой, что неэффективно использует память.
При конфликте при сохранении данных в массиве мы применяли список для записи новой информации. Этот способ разрешения коллизий называется методом цепочки. Его главный минус — формирование длинных цепочек занятых ячеек в хеш-таблице, что приводит к неравномерному распределению данных. Это замедляет операции вставки, поиска и удаления ключей.
Помимо метода цепочки, есть и другие способы обработки коллизий. Один из самых популярных — метод открытой адресации. В этом подходе при конфликте мы ищем следующую свободную ячейку в массиве. Если она занята, продолжаем поиск следующей свободной ячейки и так далее, пока не найдем место для данных. Как определить следующую ячейку? Есть несколько методов: использование нескольких хеш-функций или линейное сканирование, при котором номер ячейки увеличивается на единицу с каждой попыткой, пока не найдется свободная ячейка.
Это значит, что по хеш-значению невозможно восстановить исходные данные. Это важно для криптографии, но не обязательно для хеш-таблиц. Например, в языках программирования хеш-таблицы используются для создания ассоциативных массивов, что позволяет гибко хранить и быстро получать доступ к данным.
dict в Python — это уже готовая высокоэффективная реализация хеш-таблицы с открытой адресацией и оптимизациями.
Пример использования dict в Python
# создаем словарь с данными о пользователях
people = {
    "Joe": "M",
    "Sue": "F",
    "Dan": "M",
    "Nell": "F",
    "Ally": "F"
}

# доступ по ключу (O(1))
print("Пол Ally:", people["Ally"])
print("Пол Dan:", people["Dan"])

# добавление нового элемента
people["Tom"] = "M"
print("После добавления Tom:", people)

# изменение значения
people["Sue"] = "Female"
print("После изменения Sue:", people)

# удаление элемента
del people["Joe"]
print("После удаления Joe:", people)

# проверка наличия ключа
print("Есть ли ключ 'Nell'?", "Nell" in people)

# обход словаря
for name, gender in people.items():
    print(name, "->", gender)
Особенности встроенного dict в Python:
- Доступ к элементу по ключу — O(1) в среднем.
- При коллизиях Python сам применяет метод открытой адресации.
- Порядок ключей сохраняется (начиная с Python 3.7).